浏览器里构建视频 AI 工作流
连接视频源、AI 模型、后处理节点、OSD 渲染、告警规则与输出通道。业务标签替代原始类别名,语义化颜色区分正常 / 预警 / 违规状态。
视频接入、解码、推理、跟踪、行为分析与事件推送全部在设备本地完成;业务人员在浏览器里直接编排场景任务,数据不出设备。
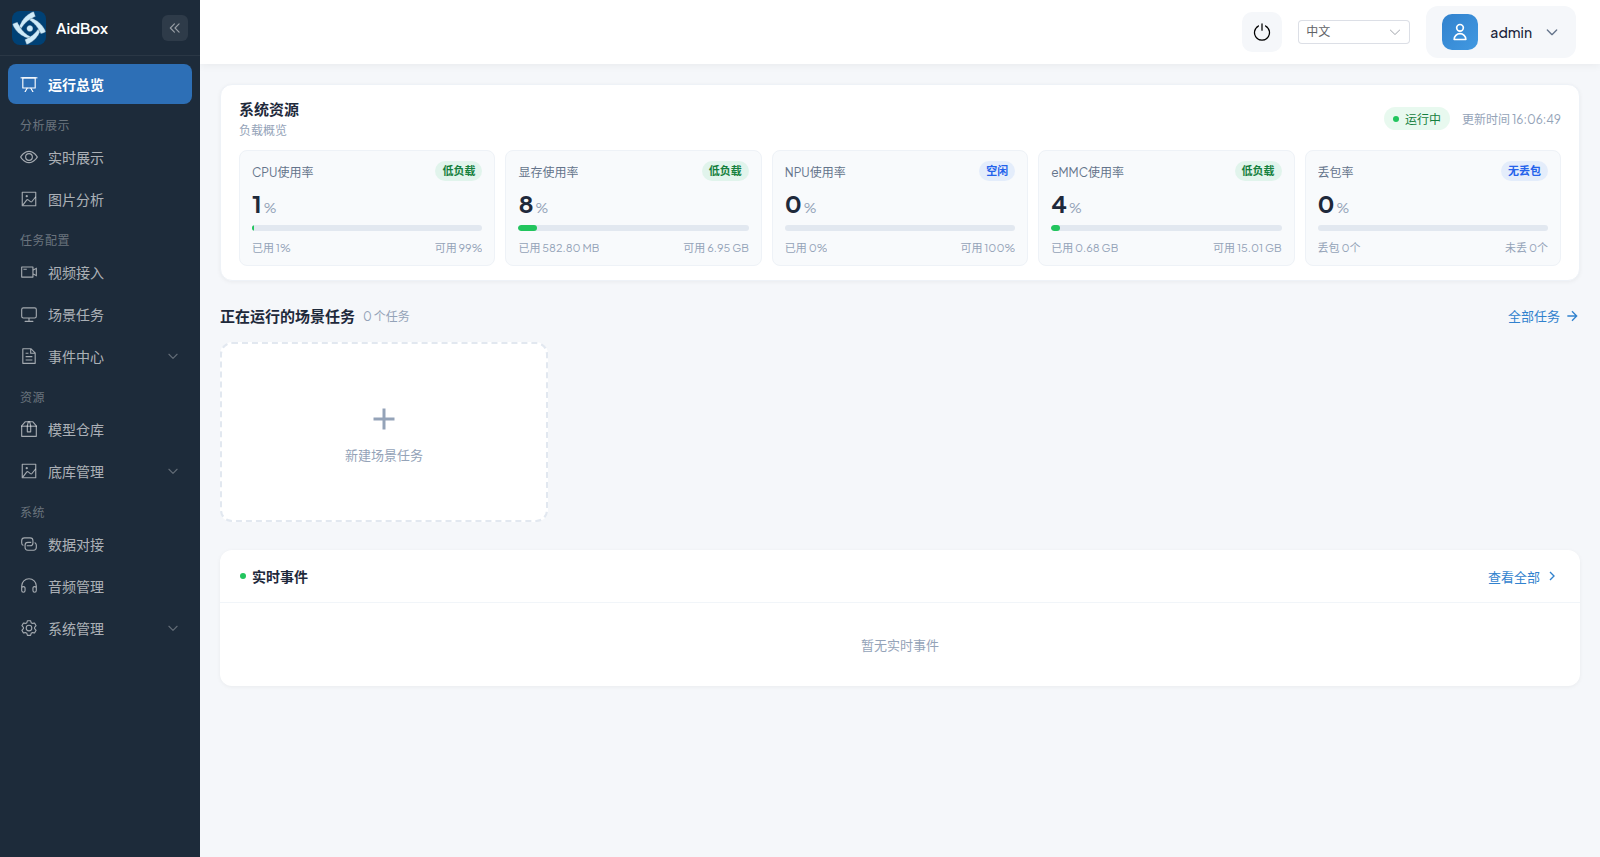
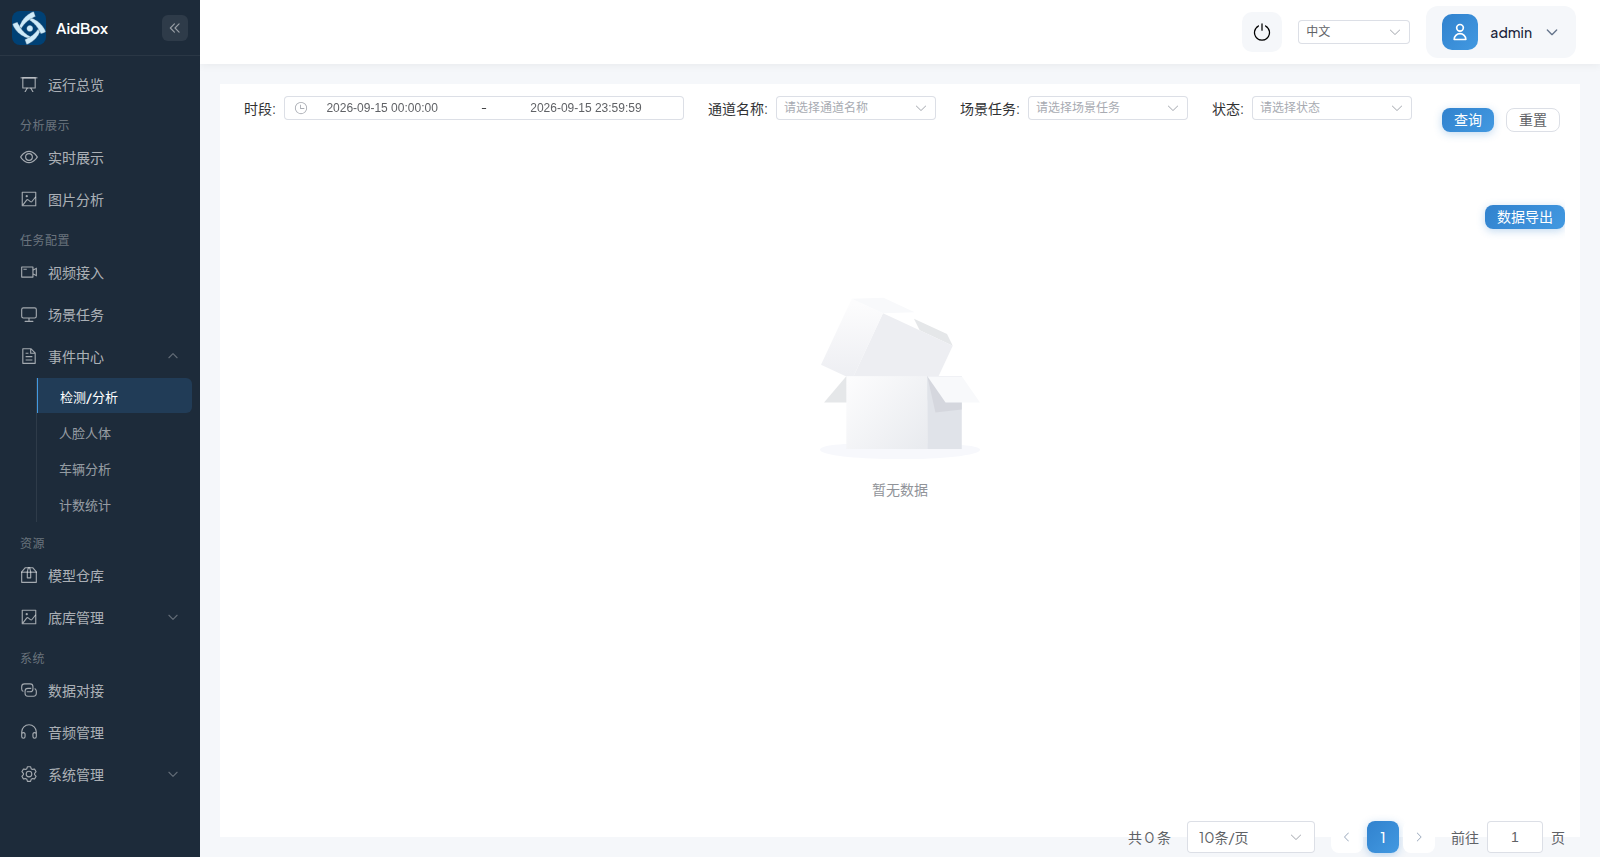
浏览器即操作台:运行总览、场景任务编排、模型仓库与事件中心,全部在 Web 端完成。
从模型到应用的一条完整链路:导入模型、编排流水线、接入视频源、浏览器查看 AI 叠加画面,并通过 MQTT / HTTP 推送结构化事件。
连接视频源、AI 模型、后处理节点、OSD 渲染、告警规则与输出通道。业务标签替代原始类别名,语义化颜色区分正常 / 预警 / 违规状态。
模型上传、元数据管理、版本管理与热替换流程;YOLOv5/8/9/11/12/26 全支持,ONNX / bmodel 双格式导入。
文本提示词检测罕见目标(无需训练);Qwen3 / Qwen3.5 VLM 完成"柜门是否打开?"式 YES/NO 视觉状态判断,支持本地运行时或 OpenAI 兼容端点。
规则引擎支持告警分级、告警截图与事件历史;结构化 JSON 事件实时推送,无缝对接业务系统与第三方平台。
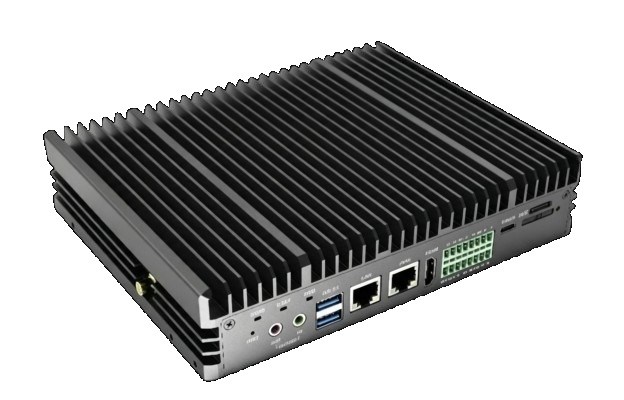
| AiDBox-16 系列 · 边缘 AI 视觉分析盒 | |
|---|---|
| 处理器 | 8 核 ARM Cortex-A53 @ 1.6 GHz |
| AI 加速器 / 算力 | INT8 16 TOPS / INT4 32 TOPS / FP16 4 TFLOPS / FP32 0.5 TFLOPS |
| 内存 / 存储 | LPDDR4,8 GB(可选 16 GB);eMMC 32 GB(可选 256 GB) |
| 视频解码 | 16 路 1080P @ 30 fps(H.264 / H.265),识别帧率 3fps 时支持同时拉流 16 路 |
| 视频编码 | 10 路 1080P @ 30 fps(H.264 / H.265) |
| 网络接口 | 以太网 ×2(10/100/1000 Mbps,WAN/LAN);M.2 WiFi+BT(802.11ax + BT4.2)、M.2 4G/5G(可选 GNSS)选配 |
| 显示 / 串口 | HDMI ×1(最高 4096×2160@60fps);RS-232 ×1、RS-485 ×1 |
| CAN / 音频 | CAN ×1;LINE_IN 单声道 ×1、LINE_OUT 双声道 ×1 |
| USB / GPIO / 继电器 | USB 3.0 ×2;GPIO ×4(2 入 / 2 出);继电器 ×1(≤36V) |
| 存储扩展 / 调试 | M.2 SATA ×1、SATA ×1、TF 卡槽 ×1;Type-C DEBUG ×1 |
| 供电 | DC 12V / 3A,运行功耗 ≤16W(被动散热,无风扇) |
| 工作温度 | -20℃ ~ +60℃(推荐 -5℃ ~ +35℃);存储温度 -40℃ ~ +85℃ |
| 湿度 / 防护 | 5%~95% RH 无冷凝;IP40,桌面或挂墙安装 |
| 尺寸 / 重量 | 200 × 160 × 43.8 mm / 1426 g |
| 操作系统 | Ubuntu 22.04 LTS |
| 订货型号 | AiDBox-16-8G32G(标准)/ 16-16G32G(大内存)/ 16-8G256G(大存储)/ 16-16G256G(大内存+大存储) |
ONNX 作为统一模型交换格式,主流训练框架产出的模型均可按文档路径导入。
| 类别 | 支持模型 / 架构 | 流水线支持 |
|---|---|---|
| 目标检测 | YOLOv5、YOLOv8、YOLOv9、YOLOv11、YOLOv12、YOLO26 | 完整流水线 |
| 目标跟踪 | ByteTrack | 完整流水线 |
| 属性分类 | 安全帽、反光背心、工服等分类器 | 完整流水线 |
| 计数与统计 | 越线统计、区域计数、方向流量 | 完整流水线 |
| 开放词汇检测 | GroundingDINO(文本提示词 → 目标检测) | 异步流水线节点 |
| 视觉状态判断 | Qwen3 VLM 系列、Qwen3.5 多模态模型(提示词 → YES/NO) | 异步节点(本地运行时 / OpenAI 兼容 API) |
| 图片分析 | VLM 批量图片分析,结构化结果输出 | 独立任务 |
模型生态兼容:Ultralytics(YOLO)yolo export format=onnx 导出、Roboflow 训练导出、自定义 ONNX 检测/分类模型,均可通过模型适配指南接入。
引擎源自商业化代码库,发布前已完成内部系统验证;以下为已验证的性能与可靠性数据。
| 范围 | 当前验证状态 |
|---|---|
| 视频压力测试 | 200 个视频样本连续播放,未观察到内存泄漏或崩溃 |
| 流水线验证 | 26 条流水线按内部场景基线完成验证(涵盖 CV、VLM 与 GroundingDINO) |
| NPU 并发负载 | ScenarioBench v1.0:NPU 设备最高 16 路 CV 视频负载稳定运行(安全帽 / 行人检测,含双算法混合场景) |
| VLM 负载 | NPU 8 路 VLM 审核通道验证通过 |
| 试点部署 | 已授权客户试点覆盖数百路视频分析,连续运行两个月以上,覆盖多个行业场景 |
| 型号 | 内存 / 存储 | 配置说明 |
|---|---|---|
| AiDBox-16-8G32G | 8 GB / 32 GB | 标准配置 |
| AiDBox-16-16G32G | 16 GB / 32 GB | 大内存配置 |
| AiDBox-16-8G256G | 8 GB / 256 GB | 大存储配置 |
| AiDBox-16-16G256G | 16 GB / 256 GB | 大内存 + 大存储配置 |
支持的算法会持续迭代,支持定制算法。具体报价与交付周期请联系销售。
不需要。AiDBox 出厂即软硬件部署完成,接电联网后在浏览器 Web 控制台即可完成全部操作——视频接入、场景任务编排、模型管理、事件查看与告警配置;无需也不支持进入设备系统层。
核心概念是"模型 + 场景任务(流水线)":26 条已验证流水线,每条都能随输入和规则变化覆盖大量实际部署。能力随编排组合扩展,而非取决于固定的算法目录。
可以。AiDBox 围绕模型导入与生命周期管理设计:ONNX / bmodel 均可通过模型仓库导入;在 AiDStudio 中训练完成的模型可一键转换后部署。
AiDBox 是面向完整边缘 AI 工作流的应用运行时——包含可视化编排、场景任务管理、告警规则与事件集成,不是单纯的模型服务层或视频录像系统。
AiDBox 源自面向生产部署的商业化开发,通过内部压力、流水线与回归验证;当前为稳定量产版本:引擎、核心工作流与发布打包均按现场交付需求设计。